
2026年10月22日,科研六组人在302会议室召开了例会。周文娟老师分享了她发表的一篇EI会议论文《基于小样本机器学习下汽车燃油经济性预测与低碳分析》,围绕研究背景、方法设计、实验结果与低碳应用进行了详细介绍,为课题组在智能汽车与低碳交通方向的研究提供了知识储备。该论文针对实际工程中实车数据有限、难以支撑大数据深度学习模型的问题,利用小样本机器学习方法建立汽车燃油经济性预测模型,并在此基础上开展碳排放测算与低碳分析,在降低试验成本的同时保证了预测精度。主要内容如下:
一、论文分享
1.研究背景与问题
(1)随着汽车保有量持续增长,燃油消耗与碳排放问题日益突出,在“双碳”目标背景下,准确预测汽车燃油经济性对节能减排具有重要意义。
(2)实际工程中,新车型或新动力总成的实车数据往往十分有限,传统深度学习模型依赖大数据,在小样本条件下容易过拟合,难以满足工程需求。
(3)台架试验与道路试验成本高、周期长,逐个工况点测量耗时费力,亟需在小样本条件下建立高精度的燃油经济性预测模型。
(4)燃油经济性与碳排放紧密关联,如何将油耗预测结果转化为碳排放测算、支撑低碳评估,也是论文关注的重点。
因此,论文希望同时解决三个核心问题:如何在有限样本下建立高精度油耗预测模型、如何对比并优选适合小样本的机器学习方法、以及如何基于预测结果开展碳排放测算与低碳分析。
2.论文核心思想
论文整体可理解为“小样本建模 + 油耗预测 + 低碳分析”的组合框架。
(1)针对实车数据有限的问题,采用广义回归神经网络(GRNN)、支持向量回归(SVR)等适合小样本的机器学习方法;
(2)基于发动机运转参数与整车行驶特征构建输入特征集;
(3)对比不同算法在小样本条件下的预测精度与泛化能力;
(4)基于油耗预测结果,结合碳排放因子测算二氧化碳排放;
(5)最终给出燃油经济性预测与低碳分析结论。
3.小样本机器学习方法
论文认为,传统BP神经网络等在小样本条件下易陷入局部最优、泛化能力下降,因此重点考察GRNN与SVR等方法。
(1)广义回归神经网络(GRNN)
GRNN具有较强的非线性拟合能力,结构简单、参数少,能够以少量样本逼近复杂映射,适合小样本建模;但平滑因子选择不当会导致预测值出现波动。
(2)支持向量回归(SVR)
SVR基于结构风险最小化,能够在小样本条件下找到全局最优解,具有良好泛化能力,超参数较少(主要是惩罚参数与核参数),适合小样本油耗预测。
(3)数据获取与样本设计
论文通过台架试验与仿真相结合,采用田口正交设计等方式减少试验工况点,仅用少量样本训练模型,并另设独立测试集验证模型在未见工况下的预测能力。
4.燃油经济性预测模型
论文以车速、加速度、比功率、发动机转速、油门开度等作为输入特征,以燃油消耗率或百公里油耗作为输出,建立多输入参数条件下的燃油经济性预测模型。
(1)特征选取:综合考虑行驶工况与动力总成参数对油耗的影响;
(2)模型训练:在少量样本下训练GRNN、SVR与BP等模型并进行对比;
(3)泛化验证:使用独立测试集检验模型在未见工况下的预测能力;
(4)结果表明:在小样本条件下,SVR、GRNN对测试点的预测精度高,多数样本相对误差较小,明显优于传统BP方法,具备工程可用性。
5.低碳分析
论文在油耗预测模型的基础上,将燃油消耗量转化为二氧化碳排放量,开展低碳分析。
(1)碳排放测算:根据油耗结果与燃料碳排放因子换算二氧化碳排放量;
(2)工况评估:结合典型行驶工况或实际行驶工况,测算不同工况下的碳排放水平;
(3)低碳建议:通过对比不同工况与驾驶方式下的排放差异,为低碳驾驶与节能技术优化提供依据;
(4)研究意义:将油耗预测与碳排放分析联动,为整车企业在低碳设计与节能评估中提供数据支撑。
6.实验与结果分析
论文在实车试验或发动机台架数据上进行了验证,主要结论如下:
(1)小样本条件下,SVR等模型的预测相对误差控制在较小范围内,预测精度满足工程要求;
(2)与传统BP神经网络相比,SVR、GRNN具有更好的泛化能力,显著降低了试验成本;
(3)基于预测结果的碳排放测算与实测值吻合较好;
(4)不同工况下碳排放水平差异明显,为低碳优化提供了量化依据。
实验说明,小样本机器学习能够在数据有限的条件下有效支撑燃油经济性预测与低碳分析,兼具精度与工程经济性。
7.论文优点与不足
优点:
(1)提出小样本条件下高精度油耗预测的可行路径,显著降低试验成本;
(2)对比多种机器学习方法,方法选择具有工程参考价值;
(3)将油耗预测与低碳分析相结合,应用场景清晰;
(4)对智能汽车与低碳交通研究具有借鉴意义。
不足:
(1)依赖数据质量,小样本难以全面覆盖极端与多变工况;
(2)模型可解释性有限,难以从机理层面解释油耗变化;
(3)针对不同车型、不同动力总成的迁移需要重新标定;
(4)碳排放测算依赖于排放因子与工况设定,存在一定误差。
8.总结
论文并非单纯提出某一种新算法,而是尝试构建一个“小样本数据—油耗预测—低碳分析”完整可落地的技术流程。它将适合小样本的机器学习方法与碳排放测算结合起来,在保证精度的同时降低试验与建模成本,贴近工程实际,对“双碳”目标下的汽车节能减排研究具有较高的实用价值。
二、组员讨论
1.关于小样本建模策略的讨论
张芸观点:论文的亮点在于针对实车数据有限的问题,选择了适合小样本的GRNN、SVR等方法,而不是一味堆叠大数据深度学习模型。她指出,传统深度学习在数据不足时容易过拟合,而基于结构风险最小化的SVR更稳健。同时她也提出疑问:如果训练数据本身含有测量误差,小样本模型是否会被噪声干扰。
别岳超观点:结合小样本特性进行了补充。他认为GRNN结构简单、参数少,对噪声有一定鲁棒性,但平滑因子需要仔细调优;SVR在小样本下能求全局最优解,更适合作为首选。讨论成员普遍认为,小样本场景下方法选择与超参数调优同样重要。
2.关于燃油经济性预测特征的讨论
孟艳平观点:重点关注了输入特征的选择。她指出,油耗受行驶工况与动力总成参数共同影响,特征选取直接决定模型上限,建议后续可进一步引入更多表征工况的特征,并结合特征重要性分析进行筛选。
许子龙观点:认为比功率、加速度等瞬态参数对油耗影响显著,论文的特征设计较为合理;但在实际行驶中,道路坡度、载重等因素也会改变油耗,小样本模型对这些变化工况的适应能力仍需进一步验证。
3.关于低碳分析的讨论
梁佳佳观点:肯定了论文将油耗预测与碳排放测算联动的思路。她指出,碳排放因子与测试工况的选择会直接影响测算结果,建议在相关报告中明确口径与数据来源,保证结果可追溯、可对比。
张芸补充观点:低碳分析对智能汽车与“双碳”研究意义重大,后续可将方法迁移到不同燃料类型与车型,形成更通用的低碳评估框架。
4.关于方法可迁移与工程落地的讨论
别岳超观点:论文方法在小样本下精度较好,但不同车型、不同动力总成间的迁移需要重新标定,建议形成标准化的数据采集与建模流程,提升工程复用性。
蒲万徐观点:小样本模型难以覆盖极端与多变工况,建议未来结合在线增量学习与迁移学习,在积累更多数据后持续提升模型的稳定性与适用性。
三、会议总结
(1)论文提供了小样本条件下高精度燃油经济性预测的可行路径,显著降低了试验与建模成本;
(2)SVR、GRNN等小样本机器学习方法相比传统BP更具泛化优势,方法选择具有工程参考价值;
(3)将油耗预测与碳排放测算联动,为“双碳”目标下的低碳评估提供了量化依据;
(4)低碳分析的口径与数据来源需要明确,以保证结果可追溯;
(5)方法在不同车型与工况间的可迁移性、小样本的覆盖能力仍需进一步研究。
通过本次讨论,小组成员进一步理解了小样本机器学习在汽车燃油经济性预测与低碳分析中的应用价值,并认识到未来研究方向将更强调:小样本高效建模、数据质量管控以及低碳评估的标准化。
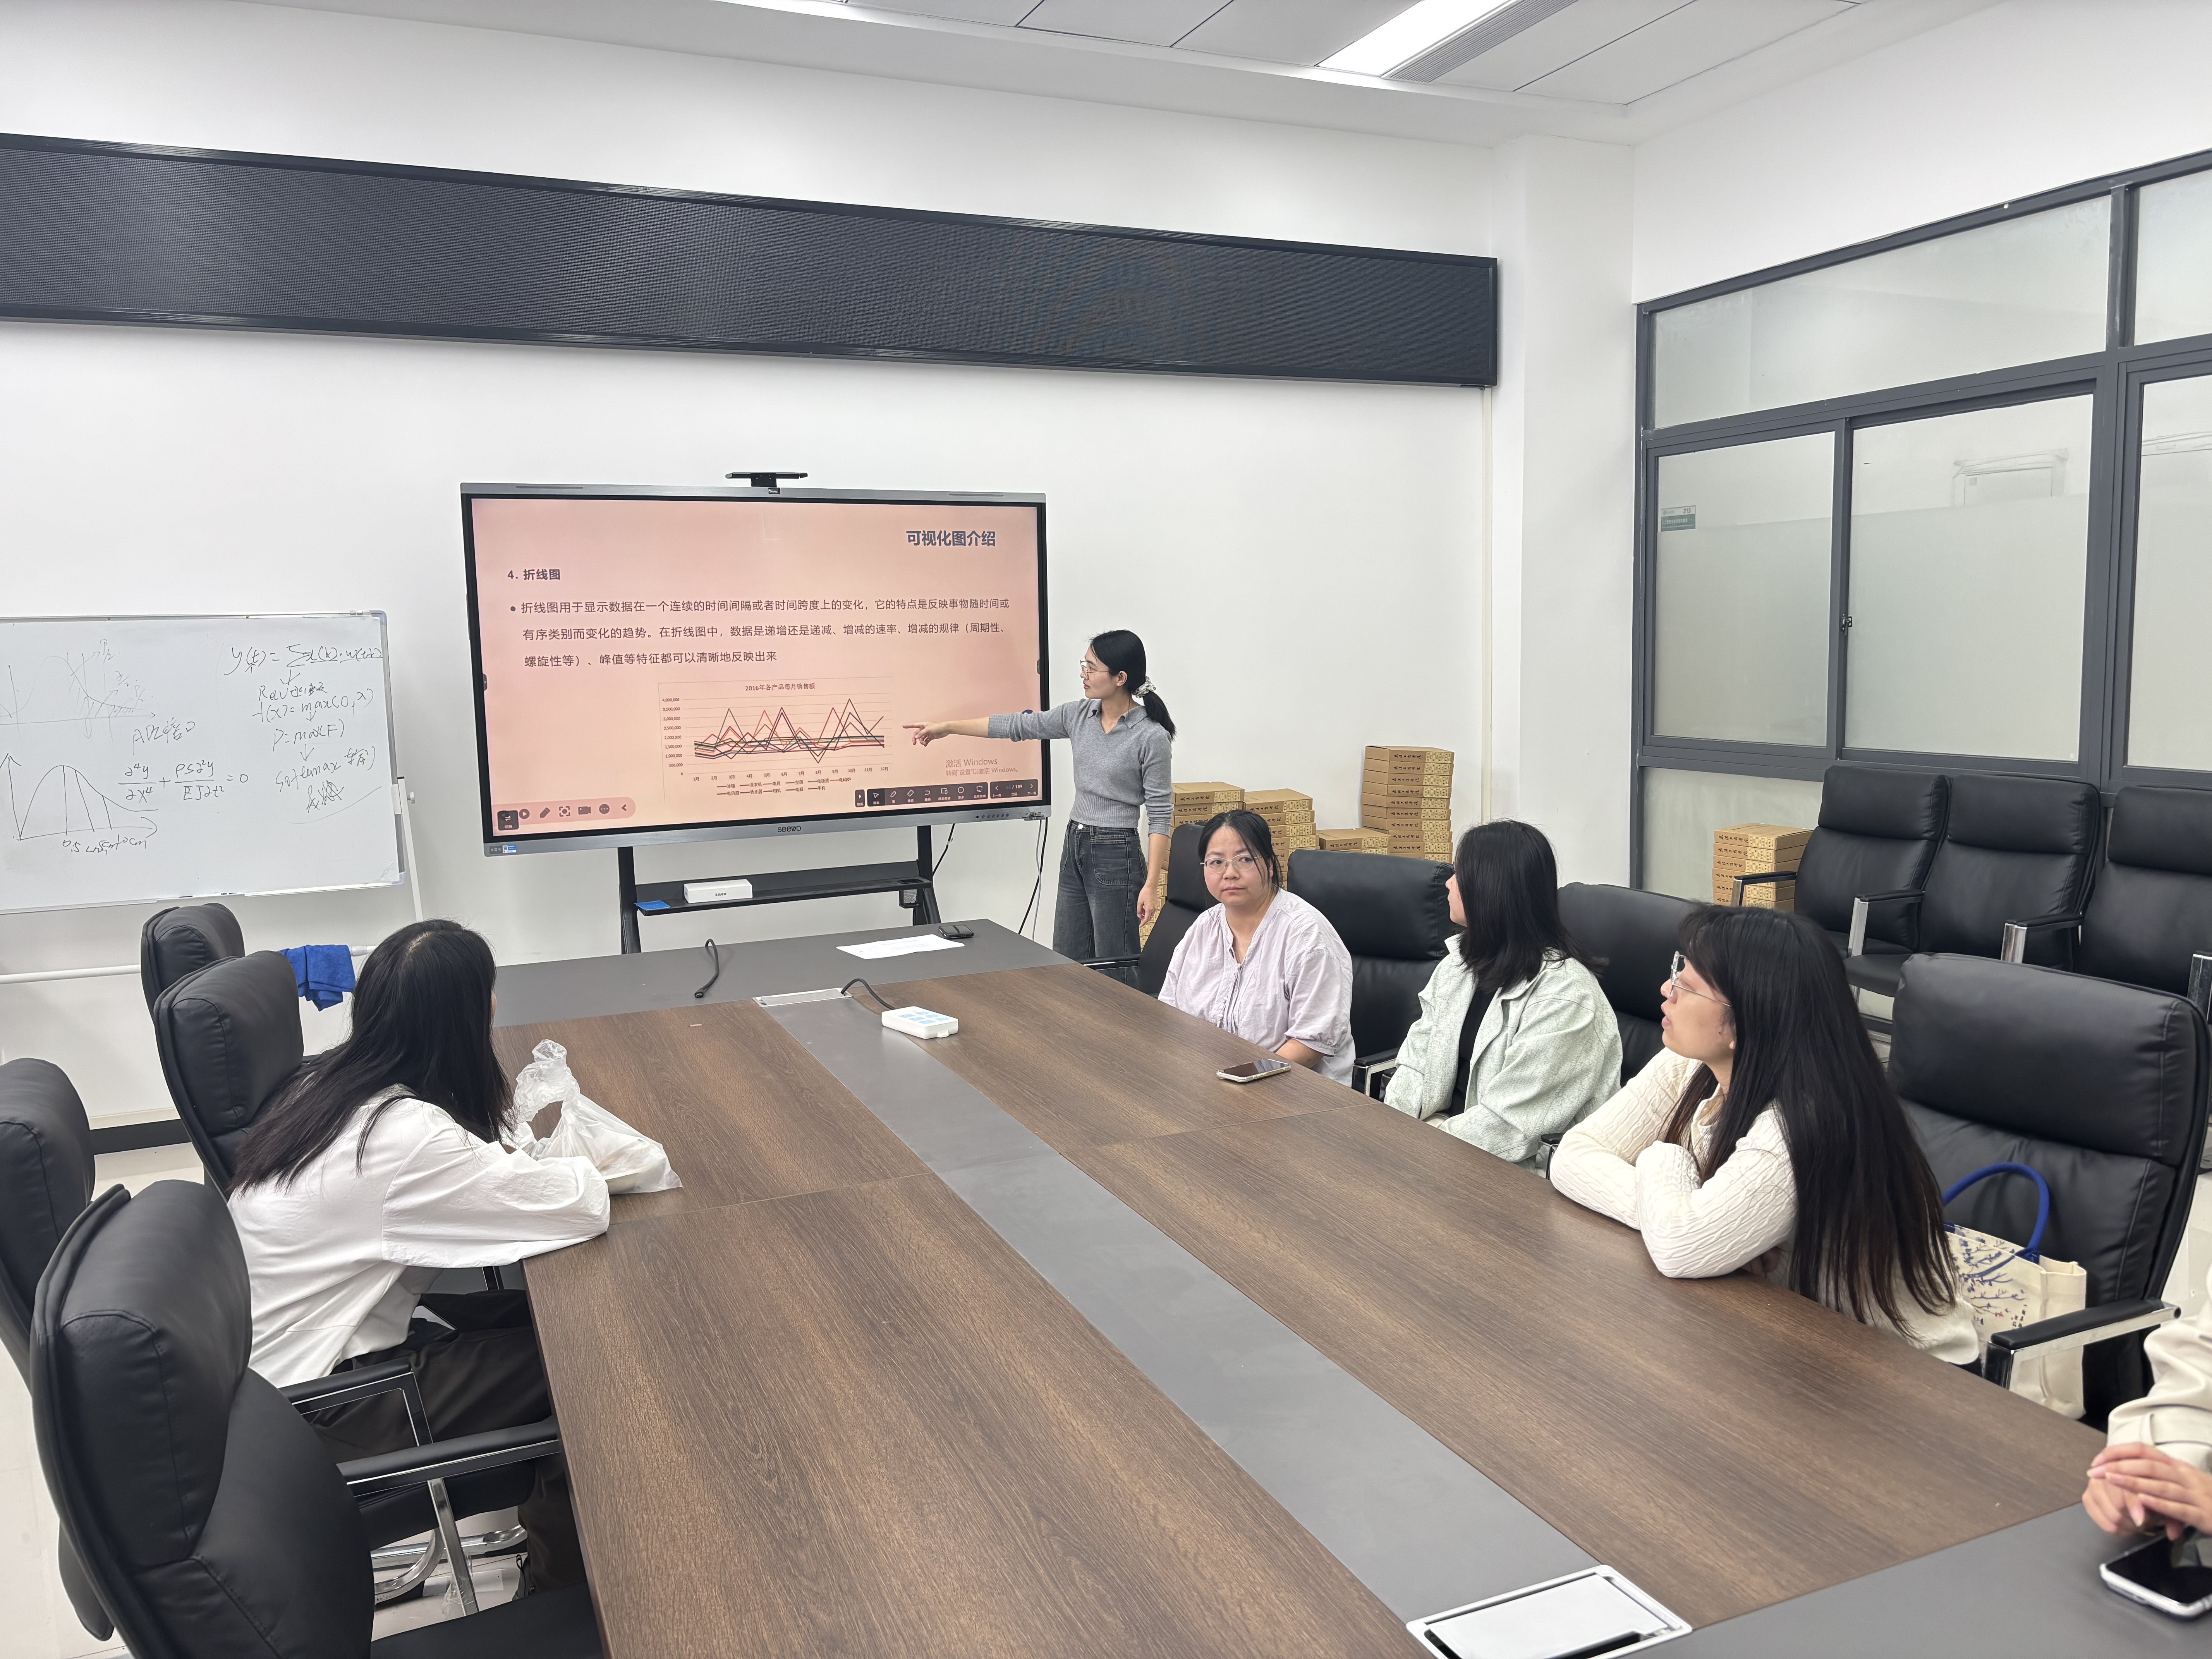
图为周文娟老师进行讲解
