
2026年10月15人工智能学院在15栋302了科研六组例会。别岳超老师汇报了课题组在智慧城市短期电力负荷预测方面的最新研究进展。重点阐述了融合时序嵌入与大语言模型的混合预测模型TSB-Forecast(Time Series BERT),该模型利用Time2Vec捕捉时间周期模式、利用SBERT从新闻文本中提取语义特征,并通过堆叠集成提升预测精度,展示了模型在短期负荷预测任务中的有效性。主要内容如下:
一、论文分享
TSB-Forecast: A Short-Term Load Forecasting Model in Smart Cities for Integrating Time Series Embeddings and Large Language Models
1.研究背景与问题
智慧城市建设的快速推进对智能能源管理系统提出了更高要求。准确的短期电力负荷预测是智能电网运行的关键环节,而电力负荷同时受到结构化时序模式(如日周期、季节周期)与非结构化外部因素(如天气异常、节假日、新闻事件和公众情绪)的共同影响。传统预测方法往往难以同时刻画这两类信息,具体存在以下问题:
(1)以ARIMA、SARIMA为代表的统计模型假设时序数据具有线性和平稳性,将时间仅作为数字索引处理,无法利用需求变化的周期性;这类方法也难以有效融合外部因素,通常只能把工作日、周末等复杂上下文简化为静态类别标签。
(2)以树模型和梯度提升为代表的机器学习方法虽然具备非线性建模能力,但主要依赖独热编码、滑动窗口等人工特征工程,缺乏处理非结构化上下文输入的机制,难以直接利用新闻文本等高维信息。
(3)以循环神经网络为代表的深度学习模型擅长捕捉序列依赖关系,但在整合新闻报道、节假日效应等高维上下文信息方面存在明显局限,在公共事件、经济波动等突发外部冲击下,也难以有效捕捉长程依赖和周期季节性。
2. 提出的算法与关键技术
汇报重点阐述了一种名为TSB-Forecast的混合机器学习模型,全称为Time Series BERT。该模型将时序建模与上下文感知相结合,整体架构分为数据准备、特征工程和模型构建三个顺序阶段:
(1)数据准备阶段:模型整合了四类数据源,包括来自ENTSO-E透明度平台的英国电力负荷数据(2016年6月至2021年5月,30分钟分辨率,共72429条样本)、伦敦每日气温与节假日数据,以及约8万篇BBC新闻文章。数据按时间划分,前四年用于训练、最后一年用于测试,时间分割点为2020年4月30日;预处理环节包括缺失值填充、新闻去重和负荷数据插值,以保证时间连续性。
(2)特征工程阶段:模型并行使用两种嵌入技术。其一是受Time2Vec启发的可学习时序嵌入,首先选取日前负荷、实际负荷、气温及多个滞后负荷等8个时序相关特征,构建48步滑动窗口(对应过去24小时的30分钟间隔数据),再通过包含两个线性层和ReLU激活的前馈网络、以均方误差为损失进行训练,最终输出64维时间嵌入(embed_0至embed_63),替代小时、星期等固定时间编码和传统傅里叶特征。
其二是基于SBERT的语义嵌入。模型采用预训练的all-mpnet-base-v2模型(基于微软MPNet架构),无需进行任务级微调,直接将新闻文章批量编码为768维稠密向量;对同一日期的多篇文章先做均值池化得到当日语义向量,再将其拼接至当日全部48个时间步,使每条记录都包含对齐的上下文信息。最终统一特征集包含97个时序特征和771个新闻特征,共868列,数值型特征统一采用z-score标准化。
(3)模型构建阶段:模型采用两层堆叠集成框架,以极端随机树回归(ETR)和XGBoost作为基学习器。ETR通过数据采样和特征选择的随机化构建低方差、抗过拟合的树群,擅长捕捉负荷与气温中的稳定趋势信号;XGBoost利用二阶梯度迭代修正误差,擅长捕捉节假日、极端天气等高波动区间的精细残差模式。随后以线性回归作为元学习器,在5折时序交叉验证中自动学习两个基学习器的组合权重,并配合网格搜索完成超参数调优。最终模型依据前48个历史值,预测次日最初两小时内4个30分钟区间的负荷。
3、初步验证与应用场景
(1)基线模型对比:
TSB-Forecast在MAE、RMSE和SMAPE三项指标上均取得最优结果,平均绝对误差为1238.42 MW,均方根误差为1678.55 MW,对称平均绝对百分比误差为3.79%,训练时间约0.83小时。相比ENTSO-E官方预测、ETR和M6等基线模型的平均表现(MAE 2020.44 MW、RMSE 2052.76 MW、SMAPE 7.68%),TSB-Forecast的MAE、RMSE和SMAPE分别降低38.7%、18.2%和50.6%。其中M6模型的MAE为1793.21 MW、SMAPE为6.78%,未使用文本数据的CNN-GRU模型SMAPE高达22.5%。
(2)消融实验验证:
消融实验进一步检验了两类嵌入的独立贡献。加入Time2Vec后,模型RMSE由2507.12 MW降至1767.79 MW,MAE由1763.81 MW降至1116.76 MW,SMAPE由5.91%降至3.76%;加入SBERT后,RMSE由2507.00 MW降至1660.00 MW,MAE由1763.00 MW降至1020.00 MW,SMAPE由5.90%降至3.39%。配对t检验结果(T=1.319,P=0.192)表明预测值与实际值之间的差异不具有统计显著性,模型不存在系统性的高估或低估倾向。
(3)深度学习对比与特征重要性分析:
在与三类深度学习模型的同口径对比中,TCN-LSTM、带注意力机制的LSTM和CNN-GRU的SMAPE分别为10.58%、5.00%和22.50%,均高于TSB-Forecast的3.79%。特征重要性分析显示,lag_43、lag_42、lag_44等滞后特征贡献最大,印证了负荷序列的强自回归性;Time2Vec生成的周期嵌入特征和SBERT语义特征同样进入重要性前列,说明模型能够同时利用周期规律与新闻事件所代表的外部上下文。
二、组员讨论
汇报结束后,与会老师围绕语义嵌入的可靠性、模型工程化部署的可行性及下一步的研究方向展开了热烈讨论。
梁佳佳老师指出,TSB-Forecast通过新闻语义嵌入显著提升了短期预测精度,但实验所用的8万余篇BBC新闻属于通用领域文本,未经能源领域标注,模型也未做领域微调,新闻事件与负荷变化之间的因果对齐缺乏细粒度验证。此外,当前对同一日期的多篇文章采用简单均值池化,可能稀释重大政策、危机等高影响新闻的信号。未来可探索基于注意力的池化或聚类聚合方法,在能源领域语料上微调SBERT,并补充不同国家和电网环境下的跨区域验证。
周文娟老师关注模型实际部署中的计算成本与预测跨度问题。统一特征集接近900列,叠加5折时序交叉验证和堆叠集成,训练开销较大,当前批处理架构并不适合亚分钟级的实时调度场景;实验同时表明,SBERT在15至30天的中期预测中表现不如RoBERTa等模型。下一步应通过模型蒸馏、分布式训练等方式降低计算开销,按预测时长自适应混合语言模型,并探索与Informer、时间融合Transformer等时序架构的集成。
三、会议总结
别岳超老师对本次汇报和讨论进行了总结:本次汇报围绕智慧城市短期电力负荷预测展开了系统性的学术交流。研究针对传统方法难以融合结构化时序信号与非结构化上下文的核心问题,提出了融合Time2Vec时序嵌入、SBERT语义嵌入与堆叠集成的TSB-Forecast模型,并在MAE、RMSE和SMAPE三项指标上全面优于统计、机器学习及深度学习基线。与会老师对多源数据融合与模块化嵌入设计的有效性给予了充分肯定,同时也就语义信号可靠性、计算效率及中期预测短板等现实挑战提出了建设性意见。
经科研小组内部讨论,下一步工作将聚焦三个方向:其一,在能源领域语料上微调SBERT,并以注意力池化、聚类聚合替代均值池化,增强新闻事件与负荷动态之间的语义对齐;其二,通过模型蒸馏、分布式学习和流式新闻管道降低计算开销,提升模型在实时及超短期场景中的部署能力;其三,将SBERT、Time2Vec与Informer、FEDformer、时间融合Transformer等时序Transformer集成到统一的端到端架构中,开展跨区域迁移验证并引入预测区间、贝叶斯集成等不确定性量化方法,为智慧城市电网的可靠运行提供技术支撑。
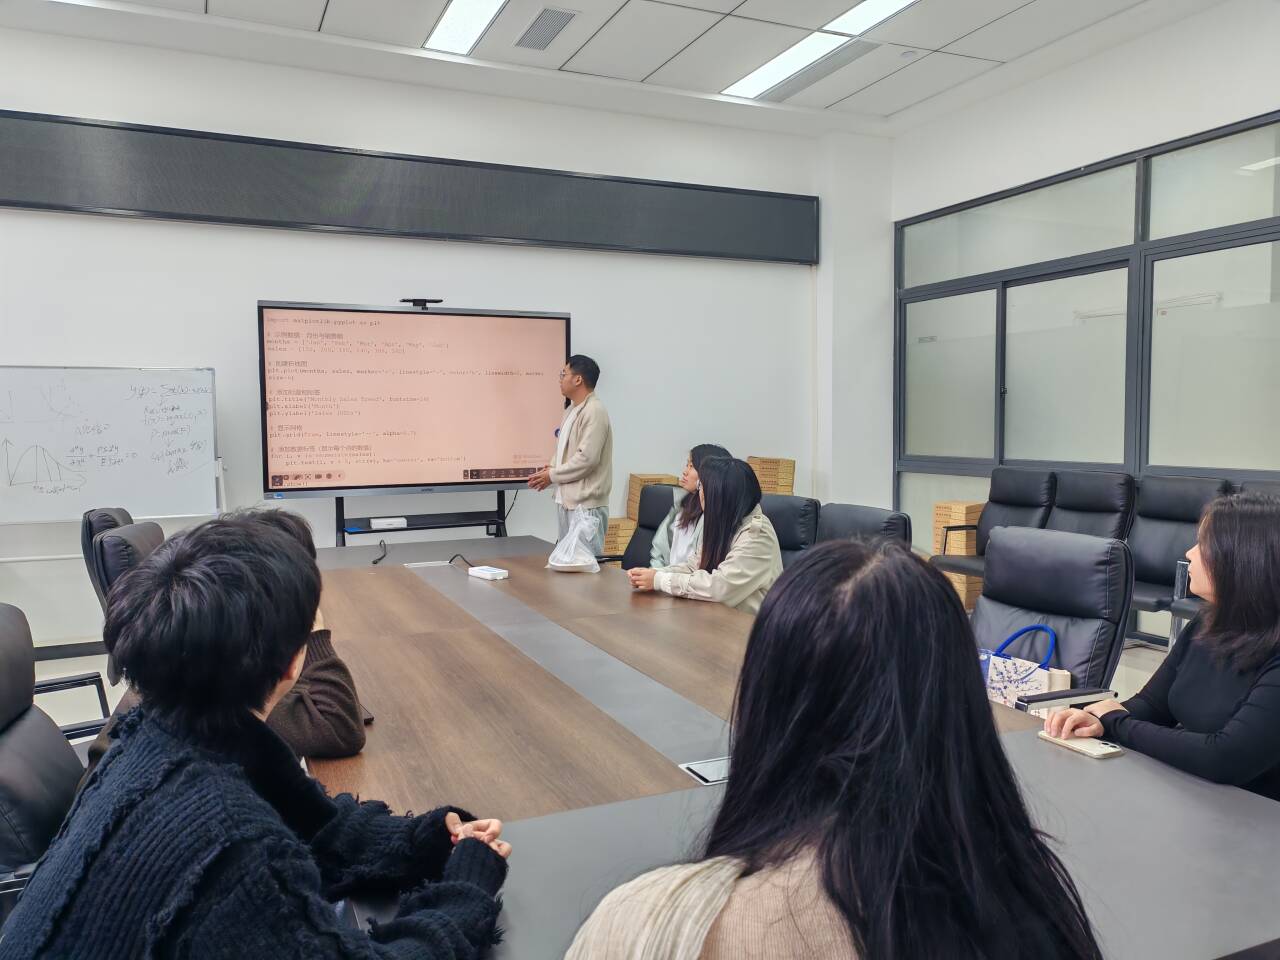
图为别岳超老师正在进行论文讲解
